Toyota Research Institute belegt in Science Robotics per Blindtest, dass Multitask-Robotermodelle neue Aufgaben mit einem Bruchteil der Daten lernen
Ein Team aus 82 Forschenden des Toyota Research Institute, der Cornell University und des MIT berichtet in Science Robotics vom 15. April 2026, dass multitaskfähige Large Behavior Models auf Basis von Diffusion Policy in verblindeten, randomisierten Versuchen besser und robuster abschneiden als Einzelaufgabenmodelle und deutlich weniger aufgabenspezifische Daten brauchen. Die Vorabfassung nennt rund 1700 Stunden Demonstrationsdaten aus mehr als 500 Aufgaben und 1800 kontrollierte Versuche am realen Roboter.
Das Toyota Research Institute (TRI) hat eine zentrale Annahme hinter den Milliardeninvestitionen in Roboter-Foundation-Modelle wissenschaftlich überprüft. In einem am 15. April 2026 in Science Robotics erschienenen Paper berichten 82 Autorinnen und Autoren, dass multitaskfähige Manipulationspolicies, von TRI als Large Behavior Models bezeichnet, erfolgreicher und robuster sind als Einzelaufgabenpolicies und komplexe neue Aufgaben mit einem Bruchteil der Daten lernen.
Das Paper mit dem Titel A careful examination of large behavior models for multitask dexterous manipulation erschien in Band 11, Heft 113. Die Beteiligten gehören dem TRI in Cambridge, Massachusetts, der Cornell University und dem Massachusetts Institute of Technology an. Erstautor ist J. Barreiros, Letztautor Russ Tedrake. Eine Vorabfassung stand seit dem 7. Juli 2025 auf arXiv.
Bemerkenswert ist weniger das Modell als die Methode. Das Team übertrug den Diffusion-Policy-Ansatz, bei dem ein Netz Roboteraktionen durch schrittweises Entrauschen erzeugt, auf einen Korpus aus simulierten und realen Roboterdaten. Anschließend verglich es die Modelle in verblindeten, randomisierten Versuchen unter kontrollierten Bedingungen mit Einzelaufgaben-Baselines, in der Simulation wie auf echter Hardware, und baute eine Auswertung mit statistischer Aussagekraft auf, heißt es in der Zusammenfassung.
Die Größenordnung steht in der Vorabfassung. TRI trainierte mehrere Modelle auf rund 1700 Stunden Roboterdemonstrationen aus mehr als 500 intern erhobenen Aufgaben plus öffentlich verfügbaren Daten und prüfte sie in 1800 Versuchen am realen Roboter. Jede reale Aufgabe lief 50-mal pro Policy und Bedingung, jede simulierte 200-mal. Die Aufgaben reichten von einfachem Greifen und Ablegen bis zu mehrstufigen Abläufen wie dem Entkernen eines Apfels, dem Decken eines Frühstückstabletts oder der Montage einer Fahrrad-Bremsscheibe.
Die Hardware war bewusst gewöhnlich. Die Vorabfassung beschreibt zweiarmige Tischstationen aus je zwei Franka-FR3-Armen mit Parallelgreifern, insgesamt neun Stationen, mit Policies im 10-Hz-Takt. Die Simulation lief auf lbm_eval, einem von TRI auf dem Simulator Drake aufgebauten Benchmark mit vier küchenähnlichen Szenarien.
Drei Kernergebnisse nennt die Zusammenfassung in Science Robotics. Multitask-Vortraining machte feinjustierte Policies erfolgreicher und robuster als Einzelaufgabenpolicies. Komplexe neue Aufgaben ließen sich mit einem Bruchteil der Daten schneller anlernen. Und die Leistung stieg vorhersehbar mit Umfang und Vielfalt der Vortrainingsdaten. In der Vorabfassung schätzen die Autoren, dass ein feinjustiertes Modell in der Simulation für vergleichbare Leistung weniger als 30 Prozent der Daten eines von Grund auf trainierten Modells benötigte. Bei der realen Aufgabe, einen Frühstückstisch zu decken, schlug ein mit 15 Prozent der Daten feinjustiertes Modell bereits die mit allen Daten trainierte Baseline.
Die Arbeit mahnt auch zu mehr Disziplin bei Erfolgsmeldungen. Die Autoren stellten die Aufgabenschwierigkeit bewusst auf Erfolgsquoten um 50 Prozent ein, bewerteten Teilerfolge mit Rubriken und prüften Unterschiede statistisch. Absolute Erfolgsquoten hingen stark davon ab, wie schwer eine Aufgabe gestaltet werde, schreiben sie, eine Warnung vor dem Vergleich von Prozentzahlen aus Firmenvideos.
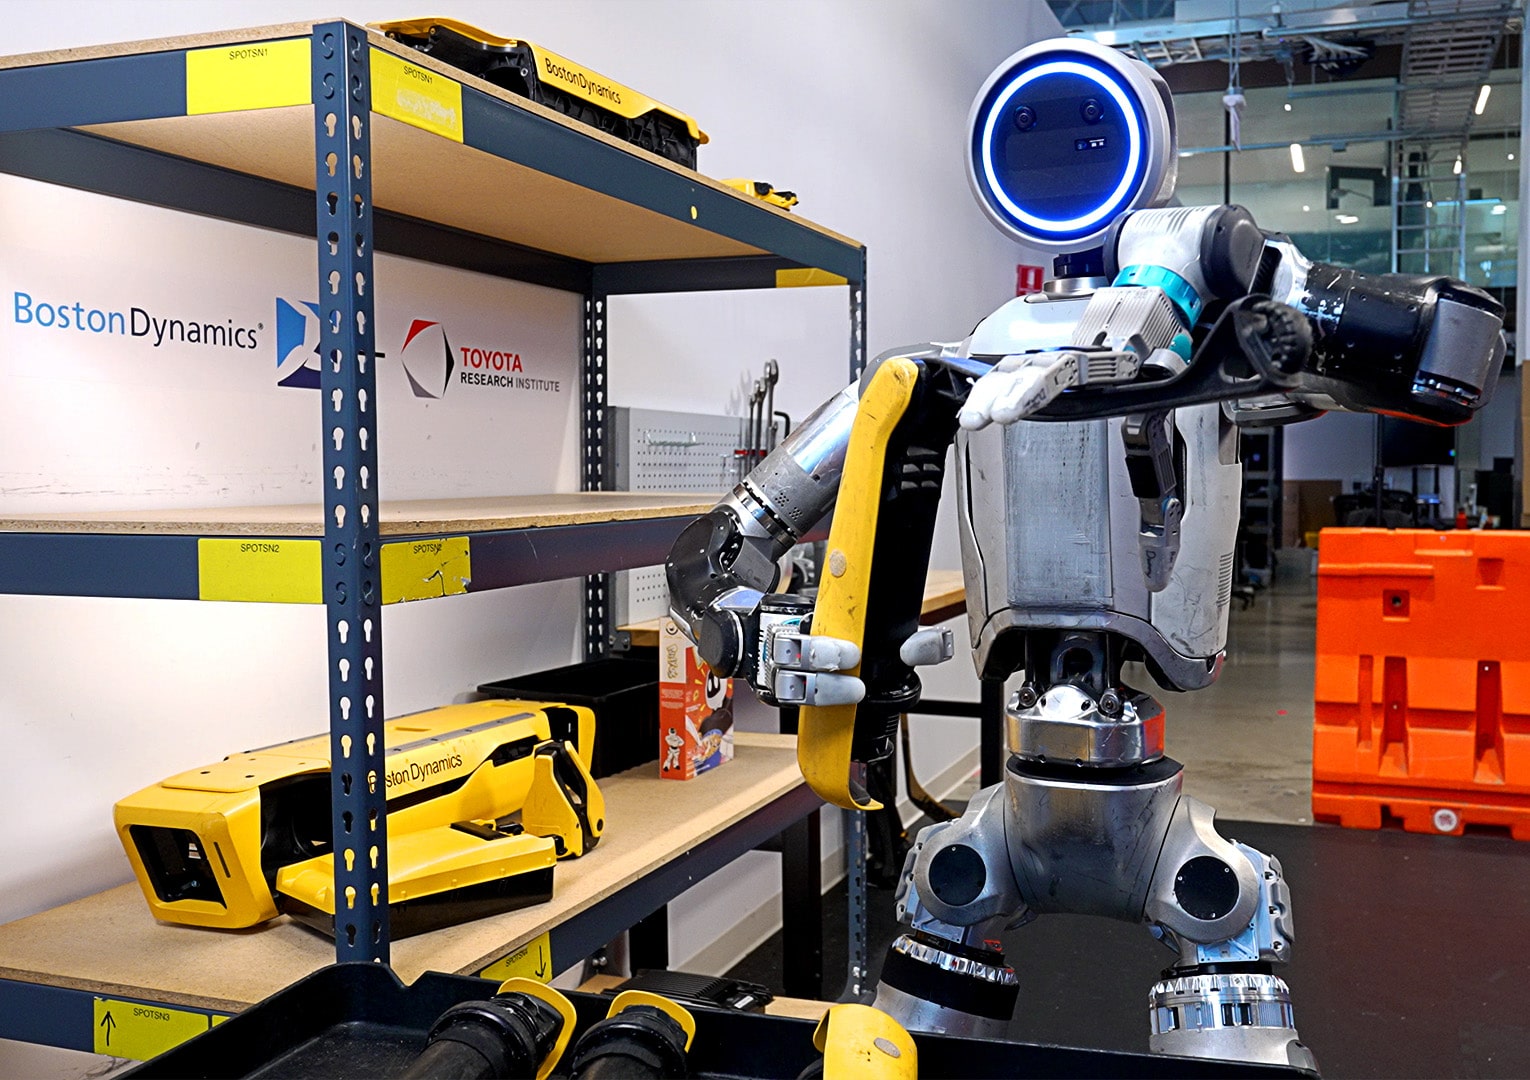
Für die europäische Industrie ist das relevant. Autohersteller und Zulieferer setzen auf Humanoide und lernende Roboter, Schaeffler und Bosch etwa als Investoren beim Londoner Start-up Humanoid. Anbieter wie Physical Intelligence, Skild AI, Figure AI, Google DeepMind und NVIDIA vermarkten generalistische Modelle, deren Bewertungen auf dem Nutzen breiten Vortrainings beruhen. TRI liefert dafür kontrollierte Evidenz. Boston Dynamics hatte im August 2025 mitgeteilt, dass seine Arbeit an Large Behavior Models für Atlas Teil einer Kooperation mit TRI ist.
Die Grenzen benennen die Autoren selbst. Laut Vorabfassung erfassen die Konfidenzintervalle nicht die Zufälligkeit des Trainings, reales Rauschen kann kleine Effekte verdecken, und die Modelle nutzten mittelgroße, per CLIP vortrainierte Sprach-Encoder statt der großen Backbones heutiger Vision-Language-Action-Modelle. Alle realen Tests liefen auf Armen mit Parallelgreifern, nicht mit mehrfingrigen Händen oder Humanoiden.
- Autoren
- 82
- Science Robotics
- Demonstrationsdaten, Stunden (rund)
- 1700
- arXiv-Vorabfassung
- Intern erhobene Aufgaben (mehr als)
- 500
- arXiv-Vorabfassung
- Reale Evaluierungsversuche
- 1800
- arXiv-Vorabfassung
- Reale Durchläufe je Aufgabe, Policy und Bedingung
- 50
- arXiv-Vorabfassung
- Simulationsdurchläufe je Aufgabe, Policy und Bedingung
- 200
- arXiv-Vorabfassung
- Roboterstationen
- 9
- arXiv-Vorabfassung
- Policy-Takt, Hz
- 10
- arXiv-Vorabfassung
Werte laut Science-Robotics-Eintrag (DOI 10.1126/scirobotics.aea6201) und arXiv-Fassung vom Juli 2025 (2507.05331). Die veröffentlichte Fassung kann Zahlen der Vorabfassung ändern.
Stand: 1. Okt. 2026
- Skild AI
- USA
- Series C
- 1.400.000.000
- 14.000.000.000
- 2026-01-14
- Figure AI
- USA
- Series C
- 1.000.000.000
- 39.000.000.000
- 2025-09-16
- Apptronik
- USA
- Series-A-Erweiterung
- 520.000.000
- Keine Daten
- 2026-02-11
- Walden Robotics
- USA
- Seed
- 300.000.000
- 1.100.000.000
- 2026-07-15
- Physical Intelligence
- USA
- Series B
- Keine Daten
- Keine Daten
- 2025-11-20
Beträge und Bewertungen laut Unternehmen oder Investoren; null, wo nicht offengelegt. Das Toyota Research Institute ist eine Forschungseinheit von Toyota ohne eigene Finanzierungsrunde.
Stand: 1. Okt. 2026
ROBOTNESS-Analyse
Das TRI-Paper ist der bislang strengste öffentliche Beleg, dass sich Multitask-Vortraining in der Robotermanipulation auszahlt, und sein größerer Beitrag könnte der Prüfstandard für eine Branche sein, die Fortschritte meist per Video kommuniziert.
Dafür spricht das Design. Verblindete A/B-Tests, 50 reale Durchläufe je Bedingung, Hunderte Simulationsläufe und statistische Trennungstests sind in einem Feld kuratierter Vorführungen selten. Dass ein mit 15 Prozent der Daten feinjustiertes Modell die volle Baseline schlug, ist eine direkte, messbare Aussage zur Dateneffizienz.
Das stärkste Gegenargument lautet, dass die getesteten Modelle eine Generation zurückliegen. Diffusion Policies mit CLIP-Encodern auf Parallelgreifern entsprechen nicht dem, was Physical Intelligence oder Google DeepMind heute ausliefern. Das Paper bestätigt einen Trend, sagt Käufern aber wenig über aktuelle Produkte.
Optimistisches Szenario. Strenge Evaluierung wird zum Verkaufsargument, Kunden verlangen statistisch belastbare Abnahmetests, und TRIs Werkzeuge auf Basis von Drake werden zur Referenz. Das Ergebnis zur Dateneffizienz stärkt den Business Case für vortrainierte Modelle in Fabriken, auch bei Toyota.
Pessimistisches Szenario. Die Branche wirbt weiter mit Videos, 50 Durchläufe je Bedingung sind für Start-ups zu teuer, und die Skalierungsgewinne flachen ab, sobald die Aufgabenvielfalt gesättigt ist, was die Skalierungskurven des Papers noch nicht ausschließen.
Signale, die zu beobachten sind:
- Ob TRI oder Partner dasselbe Protokoll auf VLA-Modelle oder Humanoide anwenden, etwa zur CoRL 2026.
- Ob ein kommerzieller Anbieter von Robotermodellen bis Mitte 2027 verblindete A/B-Evaluierungen mit veröffentlichten Statistiken in seine Produktunterlagen aufnimmt.
- Ankündigungen des Toyota-Konzerns, Large Behavior Models aus der Forschung in Werkspiloten zu bringen, auch über die Zusammenarbeit mit Boston Dynamics.
- Science Robotics, Band 11, Heft 113, eaea6201
- 15. April 2026
- 82, Toyota Research Institute, Cornell University, MIT
- Large Behavior Models auf Basis von Diffusion Policy
- Rund 1700 Stunden, mehr als 500 Aufgaben, plus öffentliche Daten
- 1800, je 50 pro Aufgabe, Policy und Bedingung
- Neun zweiarmige Franka-FR3-Stationen, Policies mit 10 Hz
- Unter 30 Prozent der Daten in der Simulation; 15 Prozent genügten bei einer realen Aufgabe
- arXiv 2507.05331, 7. Juli 2025
Warum das wichtig ist
In Roboter-Foundation-Modelle fließen Milliarden unter der Prämisse, dass Vortraining auf vielen Aufgaben Roboter günstiger anlernbar und zuverlässiger macht. Bisher stützte sich diese Prämisse öffentlich vor allem auf Firmenvorführungen und Benchmarktabellen ohne kontrollierte Vergleiche. TRI liefert verblindete, randomisierte und statistisch ausgewertete Evidenz, zumindest für diffusionsbasierte Manipulationspolicies.
Der zweite Punkt ist der Prüfstandard. Das Paper zeigt, was eine saubere Leistungsmessung kostet, mit 50 realen Durchläufen je Aufgabe und Bedingung, reproduzierbaren Startbedingungen und Rubriken für Teilerfolge. Kunden und Investoren haben damit eine zitierfähige Messlatte.
Wettbewerbsanalyse
Physical Intelligence, Skild AI, Google DeepMind, NVIDIA und Figure AI entwickeln generalistische Robotermodelle und berichten meist über interne Benchmarks oder Videos. TRI isoliert dagegen den Effekt des Vortrainings, indem es auf identischer Hardware und identischen Aufgaben gegen Einzelaufgaben-Baselines vergleicht.
In Europa entwickeln Neura Robotics und das Londoner Unternehmen Humanoid eigene Modelle und Plattformen. Für sie und für Anwender in Automobil- und Zulieferindustrie bietet das TRI-Protokoll einen Rahmen, um Lieferantenaussagen zu prüfen. Die engste industrielle Verbindung des Papers ist Boston Dynamics, das seine Atlas-Arbeit an Large Behavior Models als Kooperation mit TRI beschreibt.
Bewertungskontext
TRI ist eine Forschungseinheit von Toyota ohne eigene Bewertung. Relevant ist die Studie für private Unternehmen, deren Bewertungen auf derselben Skalierungsthese beruhen. Laut eigenen Mitteilungen sammelte Skild AI im Januar 2026 1,4 Milliarden Dollar bei 14 Milliarden Dollar ein, Figure AI im September 2025 eine Milliarde Dollar bei 39 Milliarden Dollar, Apptronik im Februar 2026 eine Series-A-Erweiterung über 520 Millionen Dollar und Walden Robotics im Juli 2026 300 Millionen Dollar Seed bei 1,1 Milliarden Dollar.
Eine strenge Bestätigung der Dateneffizienz stützt diese Bewertungen grundsätzlich. Sie hebt aber auch die Messlatte, weil Investoren nun ein öffentliches Beispiel für belastbare Evidenz haben.
Folgen für die Lieferkette
Laut Vorabfassung lief die Studie auf handelsüblichen Komponenten, darunter Franka-FR3-Arme, WSG50-Greifer, FRAMOS-D415e-Szenenkameras und FLIR-Blackfly-Handgelenkkameras. Der bindende Engpass im Roboterlernen liegt demnach bei Daten und Evaluierungskapazität, nicht bei exotischer Hardware. Für europäische Komponentenhersteller ist das ein Hinweis, dass Standardhardware in der Forschung gesetzt ist.
Entscheidend ist die Datenseite. Rund 1700 Stunden Demonstrationen über mehr als 500 Aufgaben erforderten Teleoperationsstationen, Bedienpersonal und lange Datenaufbereitung. Wer solche Mengen günstiger erzeugt, ob per Teleoperationsdienst, tragbarer Erfassung oder Simulation, besetzt eine strategische Position.
Worauf jetzt zu achten ist
Zu beobachten ist, ob TRI dasselbe Protokoll auf VLA-Modelle und Humanoide anwendet und ob die Ergebnisse dort halten. Ebenso, ob Boston Dynamics Atlas-Ergebnisse mit vergleichbarer Statistik berichtet.
Kommerziell wäre ein Signal, wenn Abnahmetests für Robotereinführungen Durchlaufzahlen und statistische Schwellen festschreiben. Das würde zeigen, dass TRIs Standard in die Beschaffung wandert.
Analystensicht
These: Multitask-Vortraining bringt in der Robotermanipulation messbare Gewinne bei Dateneffizienz und Robustheit, und TRI hat dafür die beste kontrollierte Evidenz geliefert. Konfidenz: hoch für die enge Aussage, mittel für die Übertragung auf aktuelle VLA-Produkte.
Die enge Aussage stützt sich auf Verblindung, große Stichproben und Begutachtung. Die Übertragung ist unsicherer, weil die getesteten Modelle kleine CLIP-Encoder, Parallelgreifer und Tischaufgaben nutzten, während kommerzielle Systeme große Vision-Language-Backbones, mehrfingrige Hände und mobile Plattformen einsetzen.
Offene Fragen
Bleiben die Effizienzgewinne bei VLA-Modellen mit großen Sprach-Backbones erhalten, oder schrumpfen sie, je leistungsfähiger Modelle ab Werk sind? Wie schnell flachen die Skalierungsgewinne ab, wenn die Aufgabenvielfalt über die gut 500 Aufgaben von TRI hinausgeht?
Bringt Toyota Large Behavior Models in seine Werke und legt es die Ergebnisse ebenso streng offen? Können sich Start-ups Evaluierung auf diesem Niveau leisten, oder bleibt strenges Testen den finanzstarken Labors vorbehalten?