トヨタ系TRI、多作業ロボットモデルの効果を盲検試験で実証 新作業の習得に必要なデータは一部で済む
トヨタ リサーチ インスティテュート(TRI)とコーネル大、MITの研究者82人は2026年4月15日、拡散方策に基づく多作業型の「大規模行動モデル(LBM)」が盲検の無作為化試験で単一作業モデルより成功率と頑健性が高く、新しい作業をはるかに少ないデータで習得できるとする論文を米科学誌サイエンス ロボティクスに発表した。プレプリント版によると、500超の作業にわたる約1700時間の実演データを使い、管理された実機試験を1800回行った。
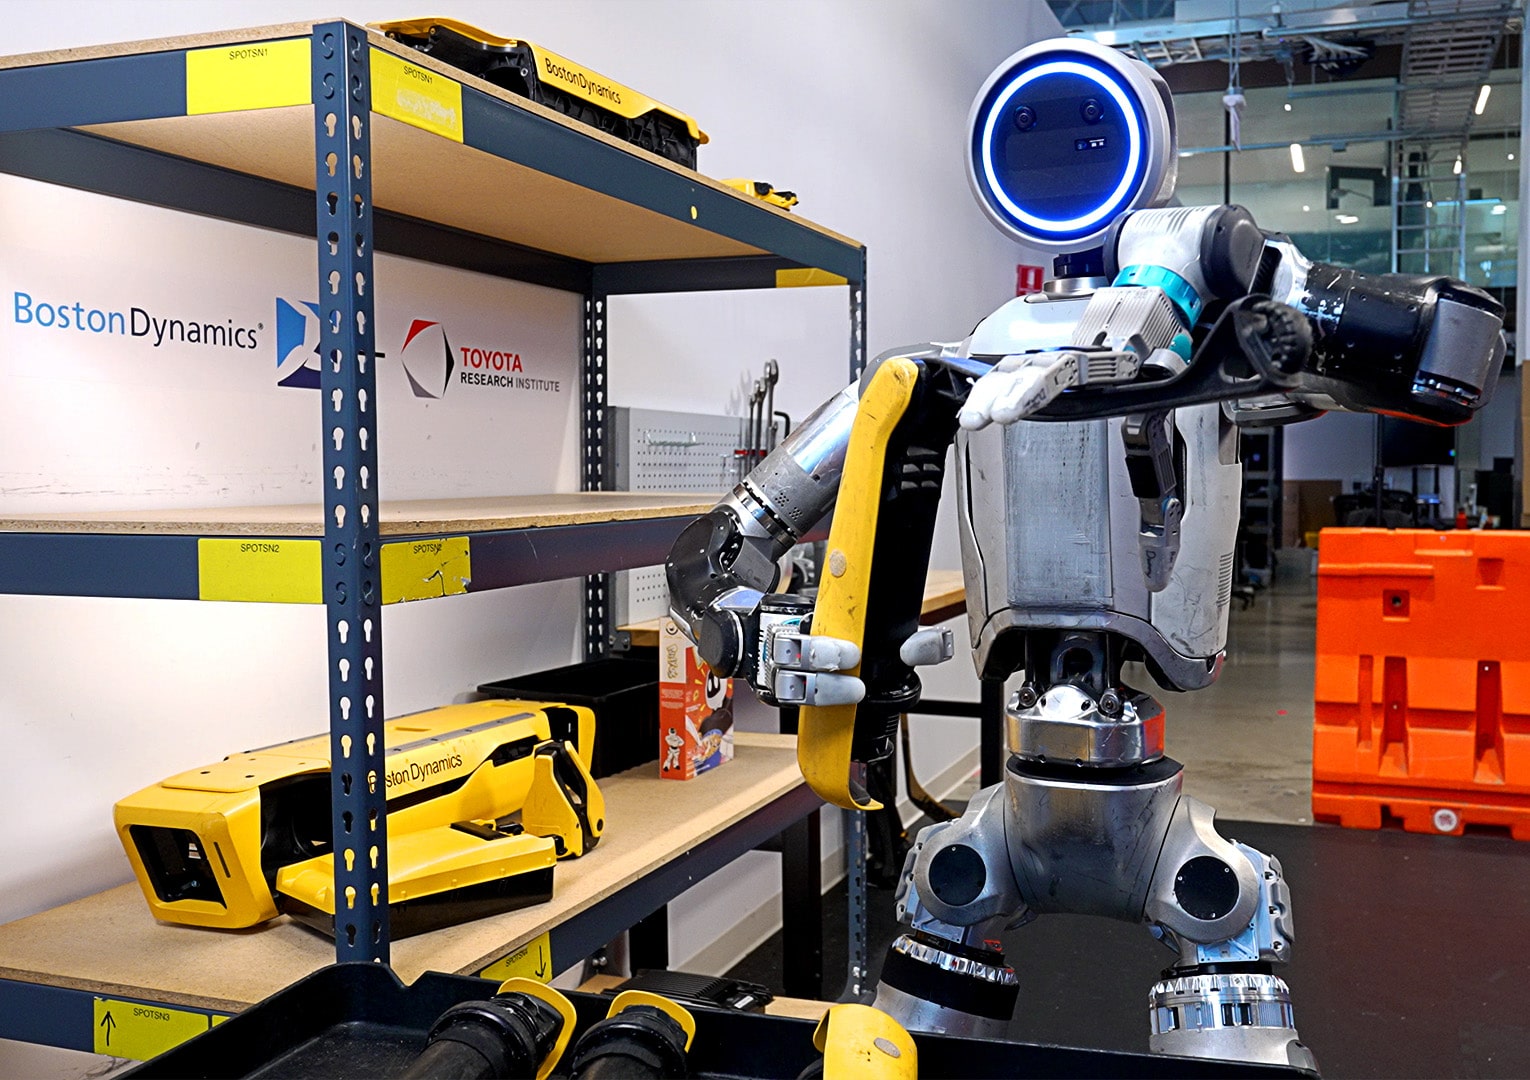
トヨタが米国に置く研究機関トヨタ リサーチ インスティテュート(TRI)は、ロボット基盤モデルに集まる投資の中心的な前提を査読論文で検証した。2026年4月15日付の米科学誌サイエンス ロボティクスに掲載された論文で、82人の研究者は、TRIが大規模行動モデル(LBM)と呼ぶ多作業型のロボット操作方策が単一作業の方策より成功率と頑健性で上回り、複雑な新作業をごく一部のデータで素早く習得したと報告した。
論文の題名は「多作業の器用な操作に向けた大規模行動モデルの綿密な検証」で、同誌11巻113号に載った。著者の所属はマサチューセッツ州ケンブリッジのTRI、コーネル大、MITで、筆頭著者はJ. Barreiros氏、最終著者はラス テドレイク(Russ Tedrake)氏。研究のプレプリントは2025年7月7日にarXivで初めて公開された。
この研究の特徴はモデルよりも方法論にある。研究チームは、ノイズを段階的に取り除いてロボットの動作を生成する拡散方策(diffusion policy)の手法を、シミュレーションと実機のデータ全体に広げた。そのうえでシミュレーションと実機の両方で、管理された条件のもと盲検の無作為化試験により単一作業モデルと比べ、統計的な信頼度を伴う評価の仕組みを整えたと要旨は説明する。
規模はプレプリント版に記されている。TRIは社内で集めた500超の作業を含む約1700時間のロボット実演データと公開データで複数のモデルを学習させ、実機で1800回の試験を行った。実機の各作業は方策と条件ごとに50回、シミュレーションの各作業は200回実行した。作業は単純な取り置きから、リンゴの芯抜き、朝食トレーの準備、自転車のブレーキローター取り付けといった多段階の作業まで幅広い。
ハードウエアは意図的にありふれたものを選んだ。プレプリントによると、平行グリッパーを付けたフランカのFR3アーム2台からなる双腕の卓上ステーションを計9台使い、方策は10ヘルツで動かした。シミュレーション評価にはTRIがDrakeシミュレーター上に構築したベンチマークlbm_evalを用い、台所を模した4つのシナリオで実施した。
サイエンス ロボティクスの要旨が挙げる主な結論は3つある。多作業の事前学習を経て微調整した方策は単一作業の方策より成功率と頑健性が高かった。複雑な新作業をデータの一部でより早く教えられた。事前学習データの規模と多様性が増すにつれ性能は予測可能な形で向上した。プレプリントで著者らは、シミュレーションでは微調整モデルが同等の性能を出すのに必要なデータはゼロから学習する場合の30%未満で、実機の「朝食の食卓を整える」作業では15%のデータで微調整したモデルが全データで学習した基準モデルをすでに上回ったとしている。
論文は成果の示し方にも規律を求めた。著者らは作業の難度を成功率50%前後に調整し、部分的な達成度を採点基準で評価し、方策間の差が本物かを統計的検定で判定した。絶対的な成功率は作業の難しさの設定に大きく左右されると明記し、企業の実演動画に出てくる成功率を横並びで比べることに注意を促した。
日本の産業にとっての意味は大きい。人手不足が深刻な製造や物流の現場では、多品種の作業を少ない教示で覚えるロボットへの期待が高い。米フィジカル インテリジェンス、スキルドAI、フィギュアAI、グーグル ディープマインド、エヌビディアが汎用ロボットモデルを競い、投資家は幅広い事前学習が報われるという前提で企業価値を評価してきた。TRIの結果はその前提を管理された証拠で裏付けた。トヨタ自身の工場や、TRIと協業するボストンダイナミクスの人型ロボットへの応用も視野に入る。同社は2025年8月、アトラス向けLBMの研究がTRIとの協業だと明らかにしている。
限界は著者自身が示した。プレプリントは、信頼区間が学習過程そのもののばらつきを反映していないこと、実機のノイズで小さな効果を見落とし得ること、現在の視覚言語行動(VLA)モデルの大型基盤ではなくCLIPで事前学習した中規模の言語エンコーダーを使ったことを挙げる。実機試験はすべて平行グリッパーのアームで、多指ハンドやヒューマノイドは含まれない。
- 著者数
- 82
- サイエンス ロボティクス
- ロボット実演データ(時間、約)
- 1700
- arXivプレプリント
- 社内収集の作業数(超)
- 500
- arXivプレプリント
- 実機評価の試験回数
- 1800
- arXivプレプリント
- 作業、方策、条件ごとの実機試行回数
- 50
- arXivプレプリント
- 作業、方策、条件ごとのシミュレーション試行回数
- 200
- arXivプレプリント
- ロボットステーション数
- 9
- arXivプレプリント
- 方策の動作周期(ヘルツ)
- 10
- arXivプレプリント
サイエンス ロボティクスの記録(DOI 10.1126/scirobotics.aea6201)と2025年7月のarXiv版(2507.05331)の開示値。掲載版でプレプリントの数値が改訂されている可能性がある。
2026年10月1日時点
- スキルドAI
- 米国
- シリーズC
- 1,400,000,000
- 14,000,000,000
- 2026-01-14
- フィギュアAI
- 米国
- シリーズC
- 1,000,000,000
- 39,000,000,000
- 2025-09-16
- アプトロニック
- 米国
- シリーズA追加
- 520,000,000
- データなし
- 2026-02-11
- ウォールデン ロボティクス
- 米国
- シード
- 300,000,000
- 1,100,000,000
- 2026-07-15
- フィジカル インテリジェンス
- 米国
- シリーズB
- データなし
- データなし
- 2025-11-20
金額と評価額は各社または投資家の開示値。非開示はnull。TRIはトヨタの研究機関で独自の資金調達ラウンドはない。
2026年10月1日時点
ROBOTNESS分析
TRIの論文は、多作業の事前学習がロボット操作で効果を生むことを示す現時点で最も厳密な公開証拠であり、より大きな貢献は動画で成果を語る業界に評価の基準を示した点にある。
根拠は設計にある。盲検のA/B試験、条件ごとに実機50回、数百回規模のシミュレーション、統計的な分離検定は、選び抜いた実演に頼るこの分野では珍しい。15%のデータで微調整したモデルが全データの基準モデルに勝ったという結果は、データ効率についての直接的で測定可能な主張だ。
最も有力な反論は、試験したモデルがすでに1世代前の技術だという点だ。平行グリッパーでCLIPの言語エンコーダーを使う拡散方策は、フィジカル インテリジェンスやグーグル ディープマインドが今出している製品とは異なる。傾向は確認したが、現行製品を選ぶ買い手への示唆は限られる。
強気シナリオ。厳密な評価が競争力となり、顧客が統計的に妥当な受け入れ試験を求め始め、Drakeを基盤とするTRIのツールが参照基準になる。データ効率の結果はトヨタを含む製造現場での事前学習モデル導入の論拠を強める。
弱気シナリオ。業界は相変わらず動画で宣伝し、条件ごとに50回の試験費用はスタートアップには重すぎ、作業の多様性が飽和すると拡張の効果は鈍る。論文の拡張曲線だけではその可能性をまだ排除できない。
注視すべき兆候:
- TRIや協業先が同じ評価手順をVLA型モデルやヒューマノイドに適用した続報を、CoRL 2026などで発表するか。
- 2027年半ばまでに、商用ロボットモデルの開発企業が統計を公開した盲検A/B評価を製品資料に採り入れるか。
- トヨタグループが、ボストンダイナミクスとの協業などを通じてLBMを研究段階から工場での試験導入へ移すと発表するか。
- サイエンス ロボティクス 11巻113号、eaea6201
- 2026年4月15日
- 82人(TRI、コーネル大、MIT)
- 拡散方策に基づく大規模行動モデル(LBM)
- 約1700時間、500超の作業、公開データを含む
- 1800回、作業と方策と条件ごとに50回
- フランカFR3の双腕ステーション9台、方策は10ヘルツ
- シミュレーションでゼロから学習の30%未満、実機の1作業で15%のデータで基準超え
- arXiv 2507.05331、2025年7月7日
なぜ重要か
ロボット基盤モデルには、多くの作業で事前学習すればロボットを安く確実に教えられるという前提のもと巨額の資金が流れ込んでいる。この論文まで、その前提を支える公開の根拠は主に企業の実演と、対照比較のないベンチマーク表だった。TRIは少なくとも拡散型の操作方策について、盲検、無作為化、統計解析を経た証拠を示した。
もう1つの意味は評価の基準だ。論文は作業と条件ごとに実機50回、再現可能な初期条件、部分達成の採点基準など、ロボット方策の性能をきちんと測るのに必要な手間を示した。顧客や投資家が企業に根拠を求める際に引用できる物差しができた。
競合分析
フィジカル インテリジェンス、スキルドAI、グーグル ディープマインド、エヌビディア、フィギュアAIはいずれも汎用ロボットモデルを開発し、多くは社内ベンチマークや動画で成果を示す。TRIの研究は同じハードと作業で単一作業モデルと比べ、事前学習の効果だけを切り出した点が異なる。
日本ではファナック、安川電機、川崎重工業が生成AIや基盤モデルとの連携を進めている。TRIの評価手順は、こうした取り組みの効果を顧客に示す際の参考になる。産業面で最も近いのはボストンダイナミクスで、同社はアトラス向けLBM研究をTRIとの協業と位置付けている。
企業価値の背景
TRIはトヨタの研究機関で独自の企業価値はない。関係するのは同じ拡張仮説に評価額を依存する未上場企業だ。各社発表によると、スキルドAIは2026年1月に14億ドルを調達し評価額140億ドル、フィギュアAIは2025年9月に10億ドルを調達し評価額390億ドル、アプトロニックは2026年2月に5億2000万ドルのシリーズA追加調達、ウォールデン ロボティクスは2026年7月に評価額11億ドルで3億ドルのシード資金を集めた。
事前学習がデータ効率を高めるという厳密な確認は、原理的にはこれらの評価額を支える。同時に、投資家に何が十分な証拠かを示す公開例ができたことで、検証のハードルも上がった。
サプライチェーンへの影響
プレプリントによると研究はフランカFR3アーム、WSG50グリッパー、FRAMOS D415eのシーンカメラ、FLIR Blackflyの手首カメラなど市販部品で行われた。ロボット学習の本当の制約は特殊なハードではなく、データと評価の能力にあることを示す。
供給面で重要なのはデータだ。500超の作業にわたる約1700時間の実演には、遠隔操作ステーション、操作要員、長期のデータ整備が必要だった。遠隔操作サービスや装着型の収集機器、シミュレーションでこの量を安く作れる企業が戦略的な位置を占める。人手不足の日本では、データ収集の人員確保そのものが課題になり得る。
今後の注目点
TRIが同じ手順をVLAモデルやヒューマノイドに適用し、結論が現行の構成でも保たれるかを確認したい。ボストンダイナミクスがアトラスの成果を同様の統計で報告するかも焦点だ。
商業面では、ロボット導入の受け入れ試験が試行回数や統計的な基準を明記し始めるかが兆候となる。TRIの基準が調達手続きに広がることを意味するからだ。
アナリストの見方
見立て:多作業の事前学習はロボット操作で測定可能なデータ効率と頑健性の向上をもたらし、TRIはその最良の管理された証拠を示した。確信度:狭い主張には高、現行VLA製品への拡張には中。
狭い主張は盲検試験、大きな標本、査読に支えられている。拡張に不確実性が残るのは、試験したモデルが小型のCLIP言語エンコーダー、平行グリッパー、卓上作業を用いたのに対し、商用システムは大型の視覚言語基盤、多指ハンド、移動型の機体へ移っているためだ。
問うべき論点
大型の言語基盤を持つVLAモデルでも同じデータ効率の向上は現れるのか、それともモデルが最初から有能になるほど縮むのか。作業の多様性がTRIの500超を超えたとき、拡張の効果はどれほど早く鈍るのか。
トヨタはLBMを自社工場に導入し、同じ厳密さで結果を開示するのか。スタートアップはこの水準の評価費用を負担できるのか、それとも厳密な試験は資金力のある研究所に限られるのか。