丰田研究院在《Science Robotics》发表盲测结果,多任务机器人模型只需少量数据即可学会新任务
丰田研究院(TRI)、康奈尔大学和麻省理工学院的82位作者于2026年4月15日在《Science Robotics》发表论文称,基于扩散策略的多任务“大型行为模型”在盲法随机试验中成功率和鲁棒性均优于单任务基线,学习新任务所需的数据也少得多。预印本显示,研究使用了覆盖500多项任务、约1700小时的机器人示范数据,并进行了1800次受控真机试验。
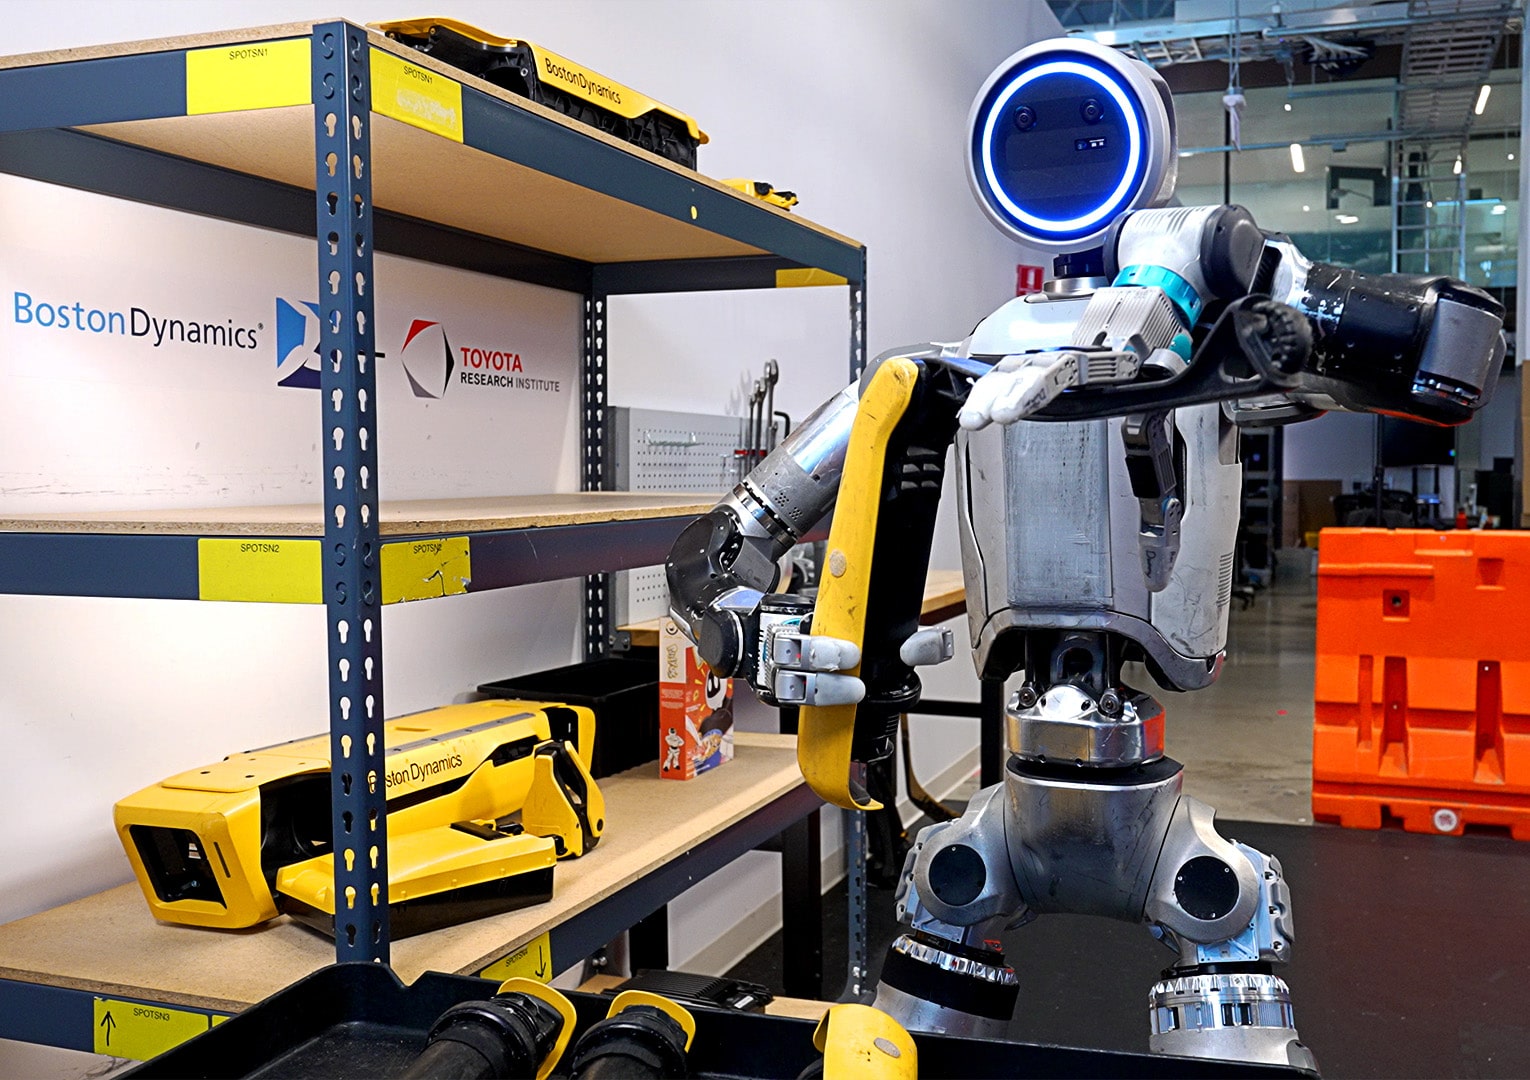
丰田在美国的研究机构丰田研究院(TRI)以一篇同行评审论文,检验了机器人基础模型融资热潮背后的核心假设。2026年4月15日刊登在《Science Robotics》的论文中,82位作者报告称,被TRI称为大型行为模型(LBM)的多任务机器人操作策略比单任务策略成功率更高、更鲁棒,并能以一小部分数据更快学会复杂新任务。
论文题为《对多任务灵巧操作大型行为模型的审慎检验》,刊于该刊第11卷第113期。作者来自位于马萨诸塞州剑桥的TRI、康奈尔大学和麻省理工学院,第一作者为J. Barreiros,最后作者为Russ Tedrake。该研究的预印本于2025年7月7日首次发布在arXiv。
这项研究的独特之处在于方法而非模型。团队将扩散策略(通过逐步去噪生成机器人动作的方法)扩展到仿真与真实机器人数据语料上,随后在仿真和真机两种环境下,于受控条件中通过盲法随机试验与单任务基线比较,并建立了能给出统计置信度的评估流程,论文摘要如此介绍。
规模数据见于预印本。TRI用约1700小时的机器人示范数据训练了多个模型,这些数据覆盖500多项内部采集任务,并加入公开机器人数据;真机评估共进行1800次试验。每项真机任务在每个策略和条件下运行50次,仿真任务各运行200次。任务从简单抓放到多步骤长程作业不等,包括给苹果去核、摆放早餐托盘和安装自行车刹车盘。
硬件刻意选用常规配置。预印本显示,平台为由两台配备平行夹爪的Franka FR3机械臂组成的双臂桌面工作站,共9套,策略运行频率为10赫兹。仿真评估使用TRI在Drake仿真器上搭建的基准lbm_eval,包含4个厨房类场景。
《Science Robotics》摘要列出三项主要结论。经过多任务预训练再微调的策略,比单任务策略成功率更高、更鲁棒;复杂新任务可以用一小部分数据更快教会;性能随预训练数据规模和多样性增长而可预测地提升。预印本中,作者估计在仿真中,微调模型达到相近性能所需数据不到从零训练的30%;在真实的“摆早餐桌”任务上,用15%数据微调的模型已超过用全部数据训练的基线。
研究也对行业的成果披露方式提出了要求。作者有意把任务难度调到成功率约50%,用评分表衡量部分完成度,并用统计检验判断策略差异是否真实存在。他们明确指出,绝对成功率在很大程度上取决于任务设计的难度,提醒外界不要横向比较各公司演示视频中的成功率。
这对中国产业同样有参考意义。国内多家具身智能企业正在推出通用操作模型,海外的Physical Intelligence、Skild AI、Figure AI、谷歌DeepMind和英伟达也在争夺同一赛道,投资者的估值普遍建立在广泛预训练会带来回报的假设上。TRI的结果用受控证据支持了这一假设,同时也为国内企业提供了一套可借鉴的评测范式。波士顿动力曾于2025年8月表示,其Atlas的大型行为模型工作是与TRI合作完成的。
作者也直言局限。预印本指出,置信区间没有涵盖训练过程本身的随机性,真机噪声可能掩盖较小的效应,所用模型采用的是基于CLIP的中等规模语言编码器,而非当下视觉语言动作(VLA)模型的大型骨干。所有真机测试都在平行夹爪机械臂上进行,未涉及多指灵巧手或人形机器人。
- 作者人数
- 82
- Science Robotics
- 机器人示范数据(小时,约)
- 1700
- arXiv预印本
- 内部采集任务数(以上)
- 500
- arXiv预印本
- 真机评估试验次数
- 1800
- arXiv预印本
- 每任务每策略每条件真机次数
- 50
- arXiv预印本
- 每任务每策略每条件仿真次数
- 200
- arXiv预印本
- 机器人工作站数
- 9
- arXiv预印本
- 策略频率(赫兹)
- 10
- arXiv预印本
数据来自Science Robotics记录(DOI 10.1126/scirobotics.aea6201)及2025年7月arXiv版本(2507.05331)。正式发表版可能对预印本数字有所修订。
截至 2026年10月1日
- Skild AI
- 美国
- C轮
- 1,400,000,000
- 14,000,000,000
- 2026-01-14
- Figure AI
- 美国
- C轮
- 1,000,000,000
- 39,000,000,000
- 2025-09-16
- Apptronik
- 美国
- A轮扩展
- 520,000,000
- 无数据
- 2026-02-11
- Walden Robotics
- 美国
- 种子轮
- 300,000,000
- 1,100,000,000
- 2026-07-15
- Physical Intelligence
- 美国
- B轮
- 无数据
- 无数据
- 2025-11-20
金额和估值均为公司或投资方披露值,未披露记为null。丰田研究院为丰田下属研究机构,无独立融资轮次。
截至 2026年10月1日
ROBOTNESS 分析
TRI这篇论文是迄今关于多任务预训练在机器人操作中有效的最严谨公开证据,而它更大的贡献可能是为主要靠视频宣传成果的行业树立了评测标准。
证据在于设计。盲法A/B试验、每个条件50次真机试验、数百次仿真以及统计显著性检验,在一个依赖精选演示的领域并不多见。用15%数据微调的模型胜过全量数据基线,是关于数据效率的直接、可测量的结论。
最有力的反驳是,被测模型已经落后一代。在平行夹爪上使用CLIP语言编码器的扩散策略,与Physical Intelligence或谷歌DeepMind当前推出的产品不同,论文确认了趋势,但对当下产品选型的参考价值有限。
乐观情景。严谨评测成为竞争力,客户开始要求统计上可靠的验收测试,TRI基于Drake的工具成为参照。数据效率结论强化了预训练模型进入工厂的商业逻辑,丰田自身也可能受益。
悲观情景。行业继续依靠演示宣传,每个条件50次试验的成本对初创公司过高,任务多样性饱和后规模效应趋缓,而论文的规模曲线尚不能排除这种可能。
值得关注的信号:
- TRI或合作方是否在CoRL 2026等场合发表将同一评测流程用于VLA模型或人形机器人的后续研究。
- 2027年年中之前,是否有商业机器人模型公司在发布材料中采用公开统计数据的盲法A/B评测。
- 丰田集团是否宣布通过与波士顿动力的合作等途径,把大型行为模型从研究推进到工厂试点。
- 《Science Robotics》第11卷第113期,eaea6201
- 2026年4月15日
- 82人,来自丰田研究院、康奈尔大学、麻省理工学院
- 基于扩散策略的大型行为模型
- 约1700小时,500多项任务,另含公开数据
- 1800次,每任务每策略每条件50次
- Franka FR3双臂工作站9套,策略10赫兹
- 仿真中所需数据不到从零训练的30%;一项真机任务用15%数据即超基线
- arXiv 2507.05331,2025年7月7日
为何重要
机器人基础模型吸引了巨额资金,其前提是多任务预训练能让机器人更便宜、更可靠地学会新技能。在这篇论文之前,支持这一前提的公开依据大多是企业演示和缺乏对照的基准表格。TRI至少在基于扩散的操作策略上,给出了盲法随机、经统计分析的证据。
其次是评测标准。论文展示了正确衡量机器人策略性能所需的代价,包括每任务每条件50次真机试验、可复现的初始条件以及部分完成度评分表。客户和投资者在要求企业拿出证据时,有了可以引用的公开标准。
竞争对手分析
Physical Intelligence、Skild AI、谷歌DeepMind、英伟达和Figure AI都在开发通用机器人模型,多数通过内部基准或视频报告成果。TRI的不同之处在于,在相同硬件和任务上与单任务基线对比,把预训练的效果单独剥离出来。
国内具身智能企业近年密集发布通用操作模型,但公开材料多以演示和自建榜单为主。TRI的评测范式为国内企业建立可信度提供了路径。产业关联方面,波士顿动力在2025年8月表示其Atlas的大型行为模型研究是与TRI的合作。
估值背景
TRI是丰田的研究机构,没有独立估值,相关性体现在依赖同一规模化逻辑的未上市公司。根据各公司公告,Skild AI于2026年1月融资14亿美元,估值140亿美元;Figure AI于2025年9月融资10亿美元,投后估值390亿美元;Apptronik于2026年2月披露5.2亿美元A轮扩展;Walden Robotics于2026年7月完成3亿美元种子轮,估值11亿美元。
关于预训练提升数据效率的严谨确认,原则上支撑这些估值;同时,投资者也有了何为合格证据的公开样本,尽调门槛随之提高。
供应链影响
预印本显示,研究全部使用商用部件,包括Franka FR3机械臂、WSG50夹爪、FRAMOS D415e场景相机和FLIR Blackfly腕部相机。这说明机器人学习的真正约束在数据与评测能力,而不在特殊硬件。
数据端才是供应链的关键。覆盖500多项任务、约1700小时的示范需要遥操作工作站、操作人员和长期的数据清洗。能够以更低成本产出同等数据量的企业,无论通过遥操作服务、可穿戴采集设备还是仿真,都将占据战略位置。国内数据采集工厂模式在这一点上具备成本优势的潜力。
后续看点
关注TRI是否把同一流程用于VLA模型和人形机器人,以检验结论在企业当前所用架构上是否成立;关注波士顿动力是否以类似统计方式报告Atlas的成果。
商业层面,一个有用的信号是机器人部署的验收测试是否开始规定试验次数和统计阈值,这将表明TRI的标准正在进入采购流程。
分析师观点
核心判断:多任务预训练能在机器人操作中带来可测量的数据效率和鲁棒性提升,TRI提供了迄今最好的受控证据。置信度:对窄口径结论为高,对延伸到当前VLA产品为中等。
窄口径结论有盲法试验、大样本和同行评审支撑。延伸存在不确定性,因为被测模型使用小型CLIP语言编码器、平行夹爪和桌面任务,而商业系统已转向大型视觉语言骨干、灵巧手和移动本体。
值得追问的问题
在采用大型语言骨干的VLA模型上,同样的数据效率提升是否依然存在,还是会随模型开箱能力增强而缩小?当任务多样性超过TRI语料中的500多项后,规模效应会多快趋缓?
丰田会把大型行为模型引入工厂并以同等严谨度披露结果吗?初创公司负担得起这种评测成本吗,还是严谨测试将只属于资金雄厚的实验室?