什么是VLA(视觉-语言-动作)模型,谁在研发
VLA(视觉-语言-动作)模型是一种把摄像头画面和自然语言指令一并读入、直接输出机器人下一步电机指令的单一神经网络,做法是在能看懂图像的视觉语言模型上再用机器人示范数据训练。谷歌DeepMind、Physical Intelligence、英伟达、Figure AI与Skild AI处于前列,智元机器人代表中国阵营,竞争焦点正从模型结构转向动作数据的获取成本。
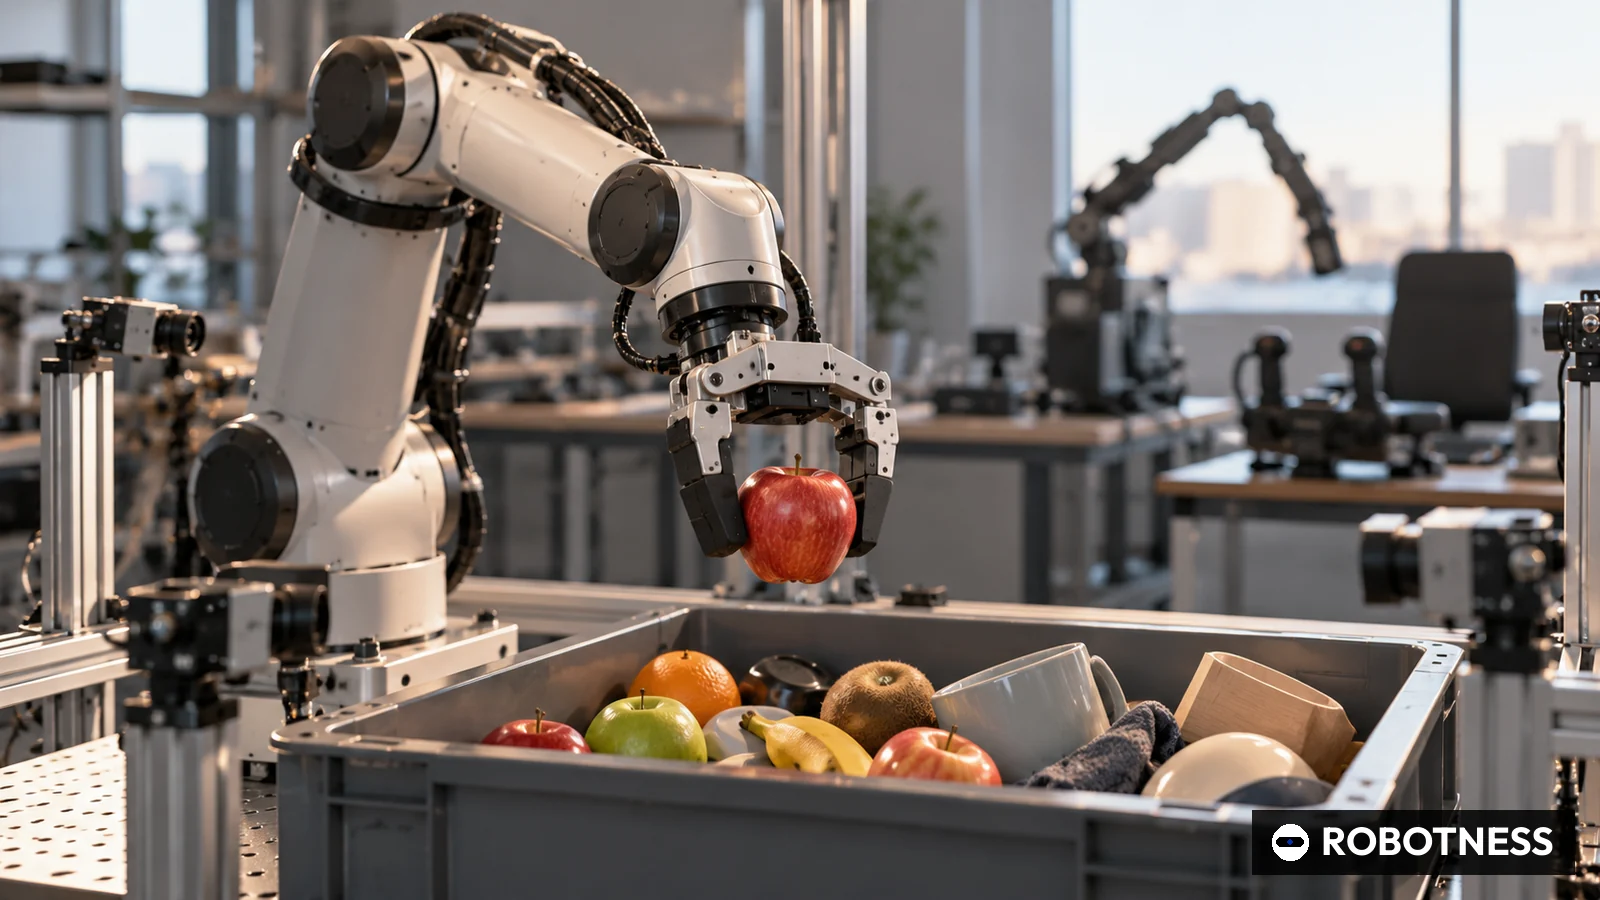
VLA(Vision-Language-Action,视觉-语言-动作)模型是一个神经网络,输入摄像头画面和“把杯子放进水槽”这样的自然语言指令,输出机器人下一步要执行的电机指令。它以能描述图片的视觉语言模型(VLM)为起点,再用机器人示范数据继续训练,使模型的输出从文字变成关节角度、夹爪开合等动作。
这一概念在2023年7月进入机器人领域。谷歌DeepMind当时以arXiv预印本发布RT-2,论文称同时学习网络图像和机器人数据后,模型在未见过的物体和场景中的成功率约为62%,而前代RT-1为32%。三年后,这条赛道的头部玩家包括谷歌DeepMind、Physical Intelligence、英伟达、Figure AI、Skild AI以及中国的智元机器人,相关公司拿下了机器人行业规模最大的几笔私募融资。本文依次说明VLA如何工作、它与传统机器人编程和世界模型有何不同、谁在领跑,以及为何数据成本而非模型结构正在决定商业胜负,这对拥有最大制造现场的中国尤其关键。
像素和语句如何变成电机指令
多数VLA由三部分组成。视觉编码器把每帧画面转成一串视觉token;语言主干即预训练的视觉语言模型,把这些token与指令、机器人自身的关节读数一起处理;动作头再把主干的内部表示换算成驱动关节、夹爪或轮子的数值。英伟达在GR00T N1模型卡中给出了清晰的结构:读取224×224像素画面的SigLIP 2视觉Transformer、T5文本编码器、随机器人本体而变化的状态网络,以及生成动作的扩散Transformer。
从视觉语言模型起步,换来的是知识迁移。用海量网络图片训练过的主干已经认识大多数家庭和工厂物品,机器人因此能处理在机器人训练中从未见过的东西。RT-2作者称,在“挑出桌上最小的物体”“把易拉罐放到只在网上见过的数字上”这类涌现能力测试中,成功率达到60%,RT-1仅为17%。接下来的问题是,网络究竟该用什么形式表达一个动作。
输出动作的两条路线,离散token与连续流
早期VLA把动作当成文字处理。论文显示,RT-2把8个动作维度,即夹爪位置与旋转6个、夹爪开合1个、任务结束1个,各自均分为256个区间,一个动作就变成语言模型像写字一样输出的一小串token。斯坦福牵头团队2024年6月开放权重的70亿参数OpenVLA沿用了这一思路,并报告在29项任务上比谷歌550亿参数的RT-2-X成功率高出16.5个百分点。
token路线对精细操作来说又慢又粗。最大的RT-2控制频率只有1至3Hz。Physical Intelligence在2024年10月31日的预印本中介绍的π0,在30亿参数的PaliGemma主干上另接一个3亿参数的“动作专家”,用与图像生成扩散方法同源的流匹配(flow matching)训练。动作专家从随机噪声出发,经10步迭代生成未来50步的动作块,控制频率最高可达50Hz。英伟达GR00T N1则用扩散Transformer完成同样的任务。
第三种设计把“思考”与“反射”分开。Figure AI于2025年2月20日发布的Helix,由运行在7至9Hz的70亿参数视觉语言模型和运行在200Hz的8000万参数策略组成,在机载的两块GPU上控制35个自由度,公司表示。英伟达把这种分工称为System 2与System 1。智元机器人2026年9月8日发布的GO-2采用异步双系统,低频的语义规划模块输出结构化动作序列,高频的动作跟随模块做残差修正以抵消环境噪声,并提出在动作空间内推理的“动作思维链”。这与国家“十五五”规划纲要提出的“大小脑一体化”机器人模型方向一致。
它既不是示教编程,也不是世界模型
传统工业机器人靠逐点编程。集成商用示教器录入路径点或离线编程,程序会一成不变地重复,直到工件位置变化或产线改造。VLA用每个控制周期都读取场景的学习型策略取代脚本,能应对杂乱的工作台和新物体,但也牺牲了便于认证的严格重复精度。日本安川电机2026年7月表示,其MOTOMAN NEXT系统用谷歌DeepMind的Gemini Robotics ER 1.6做任务规划,视觉、路径规划和力觉仍由机器人自身功能承担。
世界模型回答的是另一个问题。它预测机器人做出某个动作后场景会如何变化,通常以视频形式呈现,用来生成合成训练数据或在上真机前测试策略。Runway在9月30日表示,其世界模型中的策略结果与真实结果的相关系数为0.95。两条路线正在交汇。Runway把新发布的Praxis-1称为可直接输出控制的“世界动作模型”,Generalist AI则称其GEN-1只用可穿戴设备采集的50万小时以上人类交互数据预训练,不含任何机器人数据。
谁在做,谁在开源
谷歌DeepMind于2025年3月12日发布基于Gemini 2.0的Gemini Robotics,人形机器人合作方为Apptronik,2026年7月30日又推出面向人形机器人全身控制的Gemini Robotics 2,动作模型仍只向合作伙伴和受信测试方提供。Physical Intelligence走开源路线,其openpi仓库以Apache 2.0许可发布π0、π0-FAST,并自2025年9月加入π0.5。英伟达2025年3月18日以非商用许可发布GR00T N1,30亿参数的GR00T N1.7则以英伟达开放模型许可进入Hugging Face的LeRobot。Figure只在自家机器人上使用Helix,Skild AI以部署方式出售Skild Brain与S1,智元则通过Genie Studio平台交付GO-2。
- RT-2
- 谷歌DeepMind
- 2023-07-28
- 55
- 不开放(仅合作方)
- OpenVLA
- 斯坦福牵头团队
- 2024-06-13
- 7
- 开放
- π0
- Physical Intelligence
- 2024-10-31
- 3.3
- 开放
- Helix
- Figure AI
- 2025-02-20
- 7.08
- 无数据
- Gemini Robotics
- 谷歌DeepMind
- 2025-03-12
- 无数据
- 不开放(仅合作方)
- GR00T N1
- 英伟达
- 2025-03-18
- 2
- 开放(非商用)
- π0.5
- Physical Intelligence
- 2025-04-22
- 无数据
- 开放
- Skild Brain
- Skild AI
- 2025-07-29
- 无数据
- 无数据
- Gemini Robotics 2
- 谷歌DeepMind
- 2026-07-30
- 无数据
- 不开放(仅合作方)
- S1
- Skild AI
- 2026-08-18
- 无数据
- 无数据
- GO-2
- 智元机器人
- 2026-09-08
- 无数据
- 无数据
首次公开指首篇论文、模型卡或公司公告日期。Helix为70亿参数System 2加8000万参数System 1。π0.5权重于2025年9月经openpi开放。null表示未披露。仅用已披露数据,不作估算。
截至 2026年10月1日
开不开源是商业选择。按openpi的说明,LoRA微调只需22.5GB以上显存,一块RTX 4090即可完成,高校和中小整机厂的门槛随之下降。闭源模型则把数据飞轮和客户关系留在模型方手里。两大阵营真正的分歧在于数据成本。
成本大头是数据,而非结构
与聊天机器人不同,VLA无法从网上抓取训练数据。机器人示范数据大多靠遥操作采集,即由人操控机器人完成任务。Figure称Helix使用了约500小时遥操作数据,Physical Intelligence为π0投入了覆盖7种机器人构型、68项任务的1万小时以上数据。Skild AI在8月表示,为一项时长超过4分钟的任务采集380次示范需要50至100小时遥操作,而其S1模型凭一段视频即可取得相近效果。
英伟达称在11小时内生成了78万条合成轨迹,相当于约6500小时人类示范,与真实数据混合后GR00T N1性能提升40%。智元表示GO-2使用了数万小时交互数据。中国的优势在于场景:工信部与国资委6月要求每个省级地区开放至少20个、每家央企至少10个真实训练场景,目标是年底前形成100个以上高价值应用场景和万台级部署能力。
- Helix
- Figure AI
- 遥操作示范
- 500
- π0
- Physical Intelligence
- 机器人示范数据
- 10,000
- π0.5
- Physical Intelligence
- 移动操作(混合数据的一部分)
- 400
- GR00T N1
- 英伟达
- 合成轨迹(折算小时)
- 6,500
- LBM
- 丰田研究院(TRI)
- 机器人示范数据
- 1,700
- GEN-1
- Generalist AI
- 人类穿戴设备记录,无机器人数据
- 500,000
来源为公司公告与论文(TRI数据来自arXiv预印本2507.05331)。Helix与π0.5为约数,π0与GEN-1为下限。GR00T N1在11小时内生成78万条轨迹,英伟达折算约6500小时示范,即每生成1小时约合590小时示范(6500/11)。
截至 2026年10月1日
- 智元机器人
- 发布GO-2具身基座模型
- 2026-09-08
- 无数据
- 2025年营收超10亿元人民币
- 小鹏(Dogotix)
- 子公司签署认购协议
- 2026-08-24
- 900
- 投后估值超63亿美元
- 宇树科技
- 科创板上市
- 2026-08-18
- 无数据
- 募资61亿元人民币
- 众擎机器人
- B轮
- 2026-04-10
- 200
- 无数据
- 银河通用
- 成长轮
- 2025-06-24
- 无数据
- 11亿元人民币
来源为公司公告、港交所与上交所披露及政府网站。小鹏Dogotix金额为“超过9亿美元”的下限。人民币金额未换算美元,列为null。
截至 2026年10月1日
资金流向了哪里
据各公司披露,Skild AI于2026年1月以超过140亿美元估值融资14亿美元,Figure AI于2025年9月以390亿美元投后估值融资10亿美元,Generalist AI于2026年6月融资4亿美元。其中只有Skild公开了收入,9月10日宣布年化经常性收入(ARR)突破1亿美元,付费客户超过60家。智元则披露2025年营收超过10亿元人民币,并在2026年4月迎来第一万台机器人下线。
- Skild AI
- C轮
- 1400
- 14
- 2026-01-14
- Figure AI
- C轮
- 1000
- 39
- 2025-09-16
- Generalist AI
- 成长轮
- 400
- 无数据
- 2026-06-04
- General Intuition
- 风险融资
- 220
- 无数据
- 2026-09-29
- Dyna Robotics
- A轮
- 120
- 无数据
- 2025-09-15
- Genesis AI
- 首轮
- 105
- 无数据
- 2025-06-30
- Physical Intelligence
- B轮
- 无数据
- 无数据
- 2025-11-20
数据取自ROBOTNESS数据库最新一轮,来源为公司或投资方公告。Skild AI估值表述为超过140亿美元。估值倍增=140亿美元/2024年7月A轮投后15亿美元=9.3倍。null表示未披露。
截至 2026年10月1日
ROBOTNESS 分析
VLA模型本身正在变成共用层,长期价值将沉淀在能以最低成本持续产出有效动作数据、并掌握部署现场的一方。
证据在表格里。主干模型正向少数公开视觉语言模型收敛,20亿至70亿参数的开放VLA可以免费下载;而训练数据从Helix约500小时遥操作到GEN-1超过50万小时人类记录,相差上千倍。Skild超过140亿美元的估值约为其ARR的140倍(140亿美元/1亿美元),较2024年7月A轮的15亿美元在18个月内上升9.3倍,支撑它的是部署而非架构。对中国企业而言,这一格局有利:IDC数据显示2026年上半年中国厂商占全球人形机器人出货量95%以上,出货量就是数据来源。
最有力的反驳是,可靠性仍是模型问题。按谷歌DeepMind自己的统计,Gemini Robotics 2在Apptronik的Apollo 2上,桌面抓取成功率为68.4%,地面抓取仅45.7%。谁先靠结构创新补上这一差距,谁就可能不论数据多寡而胜出。另一个风险是算力:国产整机大量依赖英伟达Jetson平台,出口管制一旦收紧,端侧推理成本会明显上升。
乐观情景。合成数据、可穿戴采集和上下文学习持续压低数据成本,开放模型扩散到大量集成商,拥有大规模在役机队的中国厂商把出货优势转化为数据优势,智元等公司的模型收入在2028年前成形。
悲观情景。非结构化任务成功率停在六到八成,客户继续使用示教工作站加窄域AI,百亿美元级估值被证明定价的是研究领先而非业务,行业随之整合。国内大量同质化的模型发布也会被市场重新定价。
如果出现一款闭源模型在未见过的客户现场、不借助客户数据即实现90%以上成功率,我们会修正判断。值得跟踪的三个有日期的信号如下。
- 工信部与国资委专项行动的年度总结,截止日期2026年11月30日,将显示真实场景训练的实际规模。
- LG基于英伟达Isaac GR00T的双足人形机器人亮相,计划在2027年第一季度。
- Figure与Nscale用于训练Helix的Vera Rubin GPU首批部署,计划在2027年下半年。
- 读取摄像头画面与自然语言指令、输出机器人电机指令的单一神经网络
- 谷歌DeepMind RT-2,2023年7月28日arXiv预印本
- RT-2将8个动作维度各分为256个区间
- π0:30亿参数PaliGemma加3亿参数动作专家,最高50Hz
- Helix:70亿参数模型7至9Hz,8000万参数策略200Hz
- 2026年9月8日发布,动作思维链与异步双系统,数万小时交互数据
- OpenVLA(70亿)、π0与π0.5(openpi)、GR00T N1与N1.7
- Helix约500小时;π0超过1万小时
- 英伟达11小时生成78万条轨迹,约合6500小时示范
- Skild AI C轮14亿美元,估值超过140亿美元
为何重要
VLA决定通用机器人能否成为软件生意,还是停留在逐个项目定制的集成生意。若如谷歌DeepMind所说,新机型只需几小时和不到200条示范即可适配,开拓一个新场景的成本就会从工程项目降为几天的数据采集,价值重心随之从集成商与示教工程师转向模型方和掌握现场数据的一方。
对中国而言,这一问题的意义在于规模。IDC数据显示,2026年上半年中国厂商占全球人形机器人出货的95%以上;工信部预计2026年具身智能机器人产量将超过10万台。出货量越大,现场数据越多。能否把硬件规模转化为模型优势,是中国企业接下来两年的核心命题。
竞争对手分析
谷歌DeepMind拥有最强的主干与推理模型,但不造机器人,现场数据依赖Apptronik、波士顿动力等合作伙伴。英伟达通过免费开放GR00T拉动Jetson Thor和仿真平台需求。Physical Intelligence凭openpi占据研究社区,Skild AI以1亿美元ARR领先商业化。
国内阵营中,智元的路线最完整:自有整机规模、Genie Studio平台和GO系列模型形成闭环,GO-2的LIBERO平均成功率98.5%为公司自报数据。小鹏以自研芯片和汽车产线经验切入人形机器人,宇树则以硬件和价格优势占据科研与教育市场。与海外对手相比,国内企业的短板是端侧算力和基础视觉语言模型的自主程度。
估值背景
按披露数据,Skild AI超过140亿美元的估值约为其1亿美元ARR的140倍,较2024年7月A轮的15亿美元在18个月内上升9.3倍。Figure AI的390亿美元投后估值没有可比收入,无法计算倍数。
国内可比数据来自二级市场与大额私募:宇树2026年8月登陆科创板,募资61亿元人民币,发行市盈率219倍;小鹏机器人子公司Dogotix投后估值超过63亿美元。国内资本给硬件平台的定价同样不低,但模型层的独立估值尚未出现,这是与美国市场最大的差异。
供应链影响
VLA供应链分为训练算力、端侧算力与数据三部分。训练算力集中于英伟达GPU和谷歌TPU;端侧方面,LG、发那科和英伟达参考人形机器人都采用Jetson Thor。国产整机若同样依赖这一平台,将直接暴露于美国出口管制风险,小鹏自研芯片的路径因此具有战略意义。
数据是中国最大的结构性优势。工信部与国资委要求各省级地区开放至少20个、每家央企至少10个真实训练场景,“十五五”规划纲要也提出建设国家级训练场。若这些场景能产出标准化、可共享的动作数据,中国的数据成本有望显著低于海外对手。
后续看点
第一是陌生场景下的可靠性。Figure Helix 2.5在30个未见过的家庭中零样本成功率56%,是目前公开的参照线,超过90%将改变格局。
第二是国内专项行动的落地:各地与央企工作总结的截止日期为2026年11月30日。第三是模型收入:继Skild之后,是否有中国企业单独披露模型或软件收入,将决定国内模型层能否获得独立估值。
分析师观点
判断:模型层的同质化速度快于数据层,赢家将是掌握部署与数据飞轮的企业,而非动作头设计最巧妙的企业。置信度:中。
不给高置信度,是因为结构仍然重要:从1至3Hz的token方案到50Hz的流匹配、再到200Hz的双系统,是设计而非数据带来的进步。不给低置信度,是因为所有公开数据都显示,领先者与追随者的差距更多来自数据量和适配成本,而非参数规模。对中国企业而言,真实场景数据和整机规模是最可靠的护城河。
值得追问的问题
对智元:GO-2的数万小时交互数据中,遥操作、仿真与人类视频各占多少,每小时成本如何?Genie Studio的外部客户贡献多少收入?
对工信部与各地:真实训练场景产生的数据归属谁,能否在企业之间共享?对小鹏与宇树:端侧推理芯片的国产化比例和时间表是什么?