亚马逊FAR团队OmniRetarget摘得ICRA 2026最佳会议论文,宇树G1成为关键验证平台
亚马逊前沿AI与机器人团队(FAR)联合多所美国高校提出的运动重定向方法OmniRetarget,在6月于维也纳举行的IEEE ICRA 2026上同时获得最佳会议论文奖和机器人操作与运动最佳论文奖。该方法保留人体、物体与地形之间的接触关系,生成8小时以上轨迹,训练出的策略在宇树G1上无需真机微调即可完成跑酷和搬箱等动作。
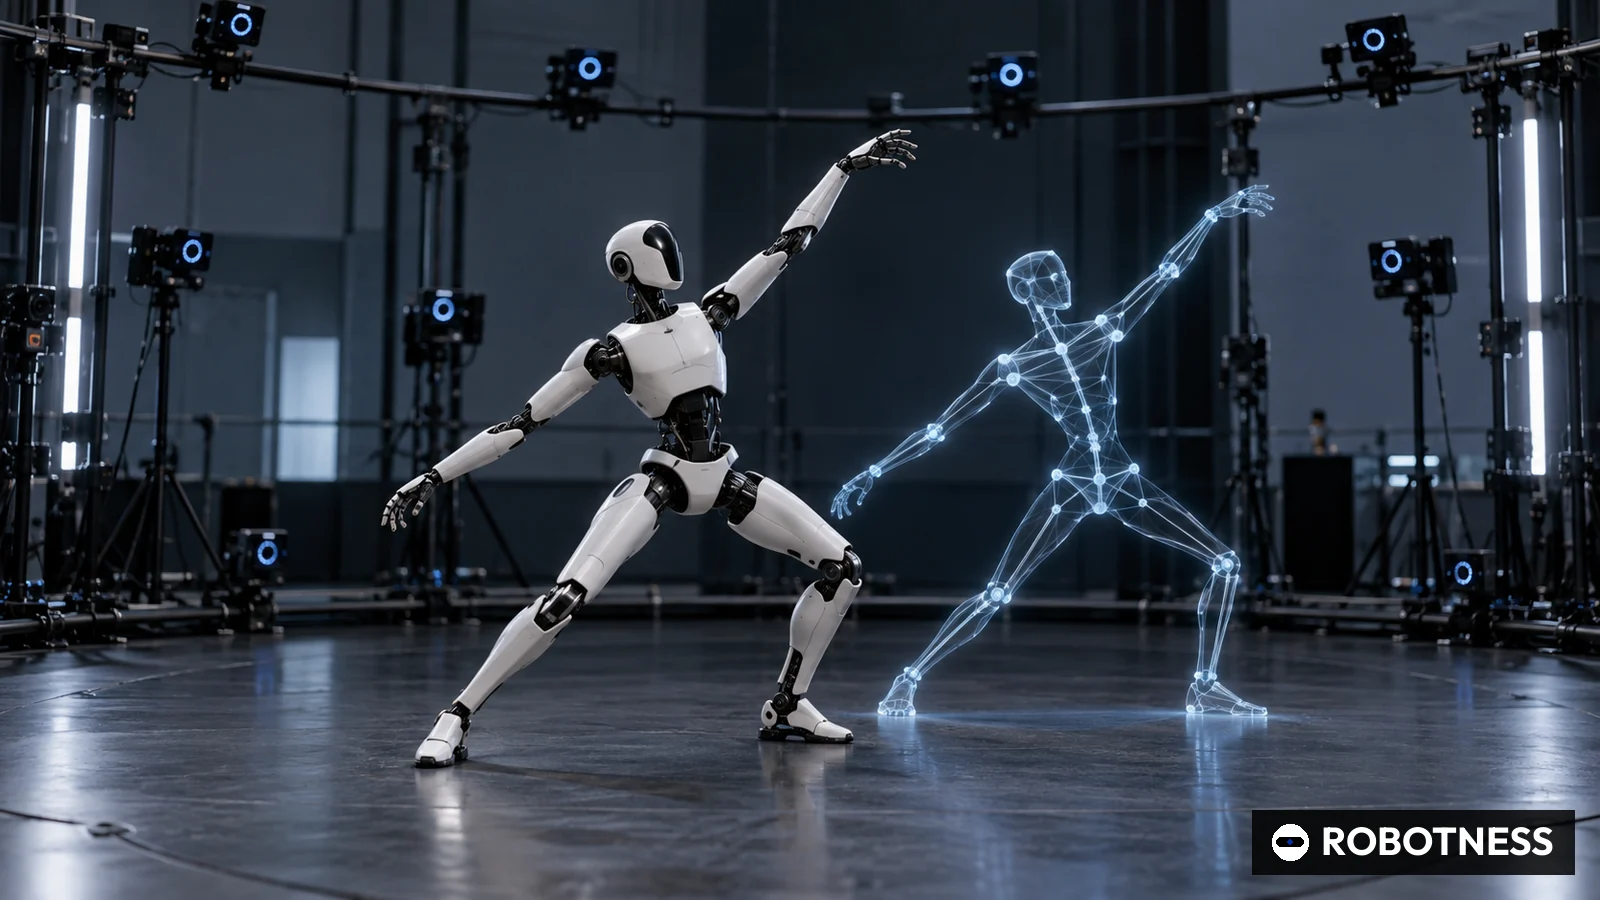
亚马逊旗下前沿AI与机器人团队(Frontier AI & Robotics,FAR)凭借一项把人类动作转化为人形机器人训练数据的方法,拿下全球规模最大的机器人学术会议的最高奖项。据项目主页和IEEE机器人与自动化学会(RAS)披露,论文OmniRetarget在6月1日至5日于奥地利维也纳举行的IEEE国际机器人与自动化会议(ICRA 2026)上,同时获得最佳会议论文奖和机器人操作与运动最佳论文奖。
论文共有9位作者。Lujie Yang、Xiaoyu Huang和Zhen Wu为共同第一作者,其余作者为Angjoo Kanazawa、Pieter Abbeel、Carmelo Sferrazza、C. Karen Liu、Rocky Duan和Guanya Shi。全部作者均署名亚马逊FAR,部分作者同时任职于麻省理工学院、加州大学伯克利分校、斯坦福大学和卡内基梅隆大学。论文于2025年9月30日首次发布在arXiv,2026年6月15日更新至第三版。
这项研究针对的是所有用强化学习训练人形机器人的团队都绕不开的瓶颈。行业通行做法是先用动作捕捉记录人体运动,再映射到机器人骨架上,作为控制策略的参考动作。作者指出,由于机器人的肢体长度、质量和关节限位都与人不同,传统重定向会产生脚底打滑、手部穿透物体等物理上不成立的伪影,同时丢失人与箱子、椅子、墙面之间的交互信息,而这些信息恰恰是移动操作的关键。
OmniRetarget的核心是交互网格。它把身体各点与周边物体和地形连接起来,记录相对位置和接触信息,再通过拉普拉斯形变把人体网格映射到机器人网格,同时施加运动学约束。论文摘要称,这样保留的是关系而不是姿态本身。IEEE RAS的文章补充说,一次人类示范可以据此扩展出物体尺寸、物体位置、地形高度乃至机器人本体不同的多种变体。
团队将该方法用于公开数据集OMOMO、LAFAN1以及自有动作捕捉数据,按论文所述生成了8小时以上的机器人轨迹,项目主页给出的数字为9小时以上。数据集已发布在Hugging Face,代码收录于亚马逊FAR的holosoma代码库,对比基线为业内常用的GMR和PHC两种重定向方法。
项目主页显示,基于这些数据训练的强化学习策略只用了5项奖励和4项域随机化,且完全依赖本体感知。在身高约1.3米的宇树G1上,策略从仿真零样本迁移到真实环境,完成了最长30秒的跑酷和移动操作序列,包括搬运箱子、登上平台、爬行、翻滚和蹬墙后空翻。
本届ICRA在11个奖项组别中共列出36篇入围论文。据各机构自行公布,德国斯图加特大学的多机器人木结构加工调度系统LASER于6月4日获得最佳学生论文奖;丰田芝加哥技术研究院(TTIC)、丰田研究院(TRI)和约翰斯霍普金斯大学合作的相机条件化模仿学习论文获得机器人学习最佳论文奖。
对中国产业而言,最值得关注的是验证平台。获奖论文的真机实验全部在宇树G1上完成,这说明国产人形机器人已成为海外顶尖实验室的默认研究硬件。另一方面,优必选、宇树、智元等国内整机企业都需要大量物理上可行的全身动作数据。波士顿动力在5月18日的博文中称,Atlas在GPU并行仿真中练习了数百万小时搬冰箱,随后在现实中搬起了超过100磅的负载,OmniRetarget解决的正是进入仿真之前的参考动作质量问题。
作者也坦承了局限。Lujie Yang在接受IEEE RAS采访时表示,该方法无法自动纠正源动作中的错误,例如动作捕捉中手的位置偏差。真机实验只覆盖一个平台,策略只用本体感知而不用视觉,意味着需要事先掌握场景几何信息。
- 最佳会议论文奖
- OmniRetarget
- 亚马逊FAR、麻省理工、伯克利、斯坦福、卡内基梅隆
- 无数据
- 机器人操作与运动最佳论文奖
- OmniRetarget
- 亚马逊FAR、麻省理工、伯克利、斯坦福、卡内基梅隆
- 5
- 机器人学习最佳论文奖
- 相机条件化的视角不变策略学习
- TTIC、丰田研究院、约翰斯霍普金斯大学
- 4
- 最佳学生论文奖
- LASER(多机器人木结构加工调度)
- 斯图加特大学
- 无数据
- 自动化最佳论文奖(入围)
- LASER
- 斯图加特大学
- 4
获奖信息依据OmniRetarget项目主页、IEEE机器人与自动化学会、约翰斯霍普金斯大学和斯图加特大学公告;入围数量依据ICRA 2026奖项页面,未公布入围名单的奖项记为null。
截至 2026年10月1日
ROBOTNESS 分析
人形机器人全身技能的稀缺要素正从模型规模转向数据质量,OmniRetarget证明了设计良好的重定向环节可以替代昂贵的真机数据采集。
证据在训练配方里。只用5项奖励和4项随机化就能完成30秒跑酷,说明大部分工作已经由参考数据完成,这也正是作者想证明的。一次动作捕捉可沿物体、地形和机型多维扩增,也改变了动捕数据的成本结构。
最有力的反驳是,人形机器人当前的收入并不来自全身敏捷性。工厂和仓储客户要的是稳定的操作能力,一个记住了场景的本体感知策略解决不了感知、不确定条件下的抓取和故障恢复。
乐观情景。这类重定向流程成为行业标准工具,让新全身任务的教学周期从数周的奖励调参缩短到数天。亚马逊拥有自有仓储网络作为试验场,有条件把方法转化为内部优势。
悲观情景。基于遥操作数据的视觉语言动作模型或视频世界模型成为主流,运动学重定向沦为细分环节。代码与数据已开源,竞争对手同样受益,奖项可能止步于学术意义。
值得关注的信号:
- 亚马逊FAR是否在2026年下半年CoRL前后发布结合视觉或精细操作的后续工作。
- 2026年第四季度Hugging Face数据集和holosoma代码库的下载与分叉数量。
- IROS 2026和CoRL 2026的评奖结果,可检验数据生成类研究是否持续获得认可。
- ICRA 2026最佳会议论文奖、机器人操作与运动最佳论文奖
- IEEE ICRA 2026,维也纳,2026年6月1日至5日
- 亚马逊前沿AI与机器人团队(FAR)
- 麻省理工学院、加州大学伯克利分校、斯坦福大学、卡内基梅隆大学
- 8小时以上轨迹(论文摘要),项目主页称9小时以上
- 宇树G1,身高约1.3米
- 5项奖励、4项域随机化,仅用本体感知
- 最长30秒跑酷与移动操作,零样本仿真到真实迁移
- Hugging Face数据集,amazon-far/holosoma代码
为何重要
多数人形机器人项目都在仿真中用强化学习训练全身技能,而输入训练的参考动作是整条链路中最耗人力、最不起眼的一环。OmniRetarget把重定向从姿态匹配改造成数据生成问题,ICRA评审同时授予全场最高奖和操作与运动单项奖,表明学界认为这一环节是真实的进步瓶颈。
其现实意义在于杠杆效应。如果一次动作捕捉可以沿物体尺寸、地形和机型扩展出大量物理可行的变体,新增一项技能的边际成本就会下降。这对没有大规模遥操作采集团队的中小整机厂尤为重要。
竞争对手分析
论文以GMR和PHC作为对比基线,这两种方法被学界和产业界广泛用于基于人体动作训练人形机器人。Figure AI、Agility Robotics、Apptronik和波士顿动力等商业公司各有内部管线,但很少公开细节。波士顿动力5月18日的文章描述了对重量、摩擦和电机差异进行随机化的强化学习训练,OmniRetarget正好处在这一环节的上游。
国内方面,宇树、优必选、智元等企业都在推进全身运动控制。宇树G1被海外顶尖团队用作验证平台,对国内厂商既是硬件认可,也意味着最先进的训练方法会最先在国产平台上被验证,有利于国内生态快速吸收。
估值背景
亚马逊没有单独披露FAR的投入或人员规模,因此不存在直接的估值关联。可参考的是依赖此类训练能力的人形机器人公司估值。根据各公司公告,Figure AI在2025年9月完成10亿美元融资,投后估值390亿美元;Skild AI在2026年1月融资14亿美元,估值140亿美元;Apptronik在2026年2月披露5.2亿美元A轮扩展。
这些估值隐含了以低成本教会机器人新技能的预期。降低数据成本的研究支撑了这一预期,但代码和数据开源后,单一公司的护城河也会被削弱。
供应链影响
真机实验使用的宇树G1是国产人形机器人,已成为海外实验室的默认研究平台,这对国内整机和关节模组供应链是正面信号。方法本身包含向其他机器人网格迁移的步骤,原则上不绑定特定硬件,因此平台地位并非不可替代。
算力方面,该流程把真机时间换成仿真时间,GPU资源成为关键约束。在高端GPU出口管制背景下,国内团队获取同等仿真算力的成本和可得性值得关注。
后续看点
其一,是否出现结合视觉的后续研究,以突破仅靠本体感知的局限。其二,国内外人形机器人企业是否在公开成果中采用holosoma代码。其三,亚马逊是否在自身披露中把FAR研究与仓储机器人部署挂钩。
时间节点上,2026年下半年的CoRL和IROS以及2027年的ICRA将检验数据生成类研究的地位。
分析师观点
核心判断:OmniRetarget表明人形机器人全身技能的瓶颈正从算法转向数据质量,而开源工具将迅速扩散这一能力。置信度:中等。
未给出高置信度,是因为实验只在单一机型上进行、依赖本体感知,演示内容由作者挑选。未下调置信度,是因为成果经过同行评审并获得双奖,代码和数据公开可复现,且与波士顿动力披露的仿真优先训练思路一致。
值得追问的问题
交互保持式重定向能否与机载视觉结合,在没有场景先验的情况下工作?面对从普通视频而非标记点动捕中提取的动作,方法能否保持同样质量?
亚马逊会把这项研究用于自家机器人,还是保持开放研究定位?如果最先进的开源训练管线持续在宇树平台上验证,国内其他整机厂如何争取同样的生态位?